Зачем LLM нужны тулы: как модель на самом деле отвечает на ваши вопросы
Меня часто спрашивают одно и то же: как сделать так, чтобы модель отвечала честно? Чтобы перепроверяла факты, не выдумывала, не «галлюцинировала»? Короткий ответ — понять, что модель вообще делает, когда отвечает, и дать ей правильные тулы. Об этом и поговорим: несколько живых демо с реальными HTTP-запросами к API, где видно, что уходит в модель и что возвращается.
Что на самом деле уходит в модель
Представьте, что вы отправляете сообщение LLM через какой-нибудь сайт. Что реально уходит на сервер? Не только ваш текст. Туда уезжает целый стек сообщений:
- system prompt провайдера модели;
- сообщение, которое добавил создатель сайта (например, «отвечай кратко»);
- и уже потом — ваш вопрос.
Базово мы передаём модели набор токенов, и она начинает генерировать ответ — на основе своих весов и всего текста, который видит перед собой.
Как модель отвечает
Я не буду здесь долго разглагольствовать про устройство трансформеров, обучение и прочую внутрянку. Для этого поста достаточно одного тезиса: LLM генерирует каждый следующий токен, исходя из того, что она видит до этого. Когда она сочиняет ответ, она видит весь предыдущий текст, видит уже написанную часть собственного ответа — и выбирает наиболее вероятное продолжение.
Условно: если показать ей начало известной книжки, она сможет продолжить текст — потому что при обучении ей показывали это начало, и за верное продолжение её «хвалили».
Можно назвать это «угадыванием следующего токена» — и формально это правда. Но делать отсюда вывод «значит, она не мыслит» я бы не спешил: мы с вами, когда говорим, тоже во многом достраиваем фразу — следующее слово само подтягивается из опыта, и мышлению это как-то не мешает. Спор о том, думает модель или нет, оставим философам. Практически важно другое: каждый символ ответа — это выбор наиболее вероятного продолжения, а не чтение из проверенного источника. А значит, вероятность поставить не ту цифру, которая нужна, у модели есть всегда — она встроена в саму механику.
Держите этот тезис в голове — все демо ниже построены вокруг него.
Демо 1. Редкий факт без тулов: рождение галлюцинации
Спросим модель про факт, которого, скорее всего, нет в надёжных источниках: рост поэта Николая Гумилёва. Вот весь диалог:
По проводу при этом уходит один HTTP-запрос:
{
  "model": "claude-opus-4-8",
  "system": "Отвечай кратко, одним-двумя предложениями.",
  "tools": — (тулов нет),
  "messages": [
    {"role": "user", "content": "Какого роста был поэт Николай Гумилёв?"}
  ]
}
И модель отвечает:
Звучит вполне разумно. Проблема в том, что этого знания у неё нет. Число 187 не взято ни из какой базы — модели просто показалось, что после единицы логично поставить восьмёрку, потом семёрку. В интернет никто не ходил: всё, что она написала, взято из весов или придумано.
{
  "stop_reason": "end_turn",
  "usage": {"input_tokens": 46, "output_tokens": 26},
  "комментарий": "Один HTTP-запрос. В интернет никто не ходил — всё, что
                  модель написала, взято из её весов (или придумано)."
}
Именно такие вещи мы называем галлюцинациями. Снаружи выглядит, как будто модель провела ресёрч. На самом деле — просто правдоподобное продолжение текста.
Как это чинится
Как заставить модель отвечать лучше, если всё, что она умеет, — достраивать текст? Нужно засунуть в её контекст текст, который уже близок к правильному ответу. Если в окно сообщений каким-то образом попадёт верный ответ — или несколько вариантов, из которых нужно выбрать, — модели будет сильно проще.
Ровно это и делают тулы: мы даём модели возможность ответить не текстом для человека, а специальным сообщением «хочу вызвать вот такую штуку» — а результат вызова кладётся обратно в контекст.
Демо 2. Тот же вопрос, но с web_search
Задаём тот же вопрос, но в запросе объявляем тулу:
{
  "model": "claude-opus-4-8",
  "system": "Отвечай кратко, одним-двумя предложениями. Если не уверен
             в факте на 100% — сначала проверь его через web_search.",
  "tools": [
    {"type": "web_search_20260209", "name": "web_search", "max_uses": 3}
  ],
  "messages": [
    {"role": "user", "content": "Какого роста был поэт Николай Гумилёв?"}
  ]
}
Теперь модель первым делом пишет текст — обычный, читаемый:
И вслед за текстом отдаёт tool_use — то самое «хочу поискать в интернете»:
{
  "name": "web_search",
  "input": {"query": "рост Николая Гумилёва поэта в сантиметрах"}
}
Важная деталь: этот поиск выполняется на сервере Anthropic, не у вас. Сервер сам сходил в поиск и получил десяток страниц:
[
  {"title": "Гумилёв, Николай Степанович — Википедия", ...},
  {"title": "Гумилев Николай Степанович — биография поэта... — culture.ru", ...},
  {"title": "Николай Гумилев - биография, новости, личная жизнь...", ...},
  {"title": "Николай Гумилев — биография... — РИА Новости", ...},
  ... ещё 6 страниц
]
Содержимое этих страниц сервер подставил модели в контекст прямо во время генерации — как будто сам отправил ей tool_result. Весь цикл «поиск → чтение → ответ» прошёл внутри одного HTTP-вызова, наш код второй запрос не делал. По метаданным это отлично видно: input-токенов стало 19 871 против 46 в первом демо — в контекст въехал огромный кусок интернета.
Финальный ответ:
Найти рост ей не удалось — зато вместо выдуманных «187–190 см» мы получили честное «не знаю». Оговорка: информацию из веб-поиска, вообще говоря, никто не проверял — её кто-то разместил в интернете, возможно, даже другая LLM. Но концептуально произошла очень полезная вещь: у нас появился механизм класть в контекст модели данные, полученные надёжным способом, — и дальше она разбирается уже с ними.
Демо 3. Событие после cutoff
Совсем короткое демо. Спросим модель без тулов про то, что произошло позавчера:
Это не «глупость» модели: финалисты определились после конца её обучающих данных — knowledge cutoff. В весах этого факта нет и быть не может. Забавно, что про место проведения она знает: статьи о будущем турнире в обучающую выборку попасть успели.
Теперь новый чат, та же модель, но с тулой web_search и одной важной добавкой в system prompt — сегодняшней датой. Модель ведь не знает даже её: без даты она уверена, что лето 2026-го ещё не наступило, и искать не пойдёт.
Модель идёт в поиск и возвращается с ответом:
Cutoff перестал быть границей: тула дотянулась до фактов, которые появились в мире уже после обучения модели. Фактически происходит немного читерства — модель пишет ответ, когда в её предыдущих сообщениях уже лежит текст с этим ответом.
Кстати, отсюда же растёт известный эффект: если вы случайно занесли в чат неверную информацию, модель будет продолжать на неё опираться. Она не умеет забывать — для неё это просто длинный ввод, внутри которого «ответ» уже есть.
Демо 4. Тула ищет в вашей базе знаний
Веб-поиск — не единственный и не лучший источник. Можно вообще не ходить в интернет: если вы собрали у себя на компьютере, скажем, досье на всех поэтов, дайте модели тулу «посмотри в моих файлах» — и качество ответов станет другим.
Объявляем собственную тулу get_person_card:
"tools": [{
  "name": "get_person_card",
  "description": "Возвращает карточку человека из личной библиотеки
                  знаний (файлы на локальной машине пользователя).",
  "input_schema": {
    "type": "object",
    "properties": {"name": {"type": "string"}},
    "required": ["name"]
  }
}]
Модель послушно отвечает: «Проверю карточку в вашей библиотеке» — это она просто написала текст, — а затем текстом же, в формате, которому её научили, просит вызвать тулу:
{
  "name": "get_person_card",
  "input": {"name": "Николай Гумилёв"}
}
Дальше — ключевой момент. Функция выполняется на моём компьютере. Это может быть любой код, который вы написали и дали модели право вызывать. У меня она читает файл kb/gumilev.md:
# Гумилёв Николай Степанович
- Годы жизни: 1886–1921
- Род занятий: поэт, основатель акмеизма, путешественник
- Рост: 176 см (запись из нашего семейного архива)
- Примечание: в открытых источниках рост не упоминается —
  эта цифра есть только в нашей картотеке.
Содержимое карточки мы отправляем обратно в API как tool_result — вторым HTTP-запросом, в котором лежит вся история: вопрос, «хочу вызвать тулу», результат:
{
  "type": "tool_result",
  "tool_use_id": "toolu_01CLHE2ah5QR4VDVGZ2FrxqE",
  "content": "# Гумилёв Николай Степанович\n... Рост: 176 см ..."
}
И модель отвечает:
Ответ собран не из интернета и не из весов, а из файла на моём компьютере.
Тут надо быть очень аккуратным, и это, пожалуй, главное предупреждение поста. Модель не копирует текст из карточки в ответ. Она всё так же порождает токены один за другим — и теоретически могла написать 178 там, где в карточке 176. Просто когда в контексте уже лежит «Рост: 176 см», вероятность того, что после «1» она поставит «7», а потом «6», становится подавляющей. Гарантий — нет; резкий сдвиг вероятностей — есть.
Демо 5. Шахматы: «интуиция» против Stockfish
До сих пор речь шла про поиск информации. Но «хочу вызвать тулу» помогает не только искать — считать тоже. Я люблю шахматы, так что пример будет шахматный.
Отправляю модели позицию в удобном формате и прошу проанализировать:
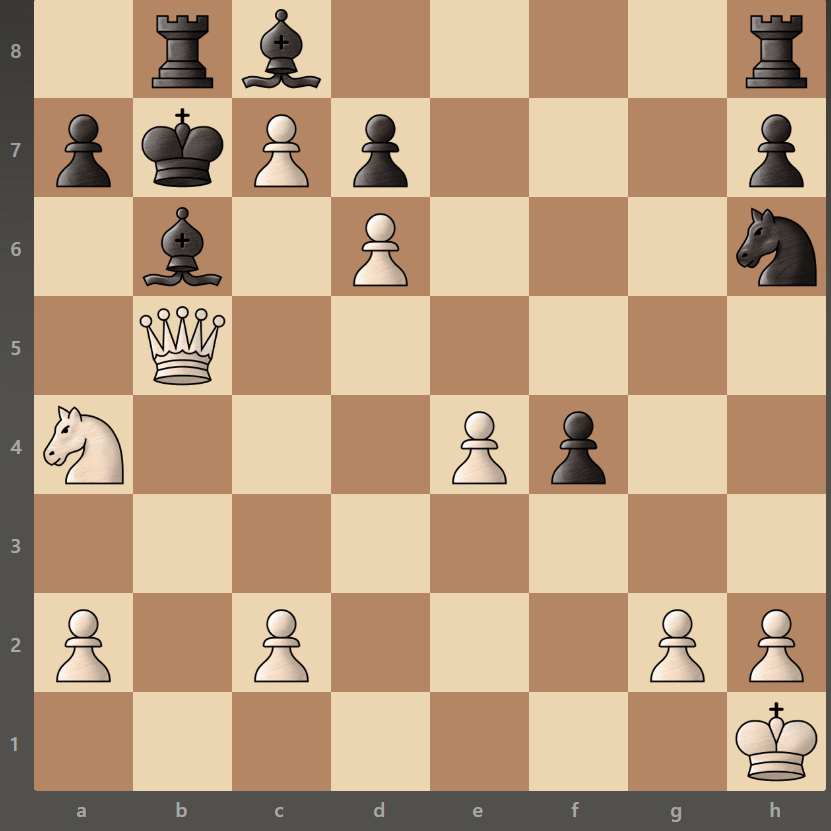
Без тулов ответ получается потрясающий — в обе стороны сразу. Смотрите сами:
Лучший ход: 1.Qxb6+!!
Жертва ферзя ведёт к мату:
— 1...Kxb6 (или 1...axb6) 2.Na4+... — нет, точнее:
1.Qxb6+ Kxb6 2.Nc4+ (двойной шах от коня и вскрытие) — нет, разберём аккуратно.
Классическое решение этой известной задачи (Ott, 1953):
1.Qxb6+! Kxb6 (если 1...axb6, то 2.Nc4! с угрозой мата и продвижением пешки) 2.Na4+ Kxc7 (2...Ka5 3.Nc3! с матовой сетью) 3.Nc5 — и белые с решающим перевесом, реализуя проходные пешки c7 и d6.
Ответ прекрасен с двух сторон сразу. С одной — модель написала «(Ott, 1953)», и это правда: задача действительно из сборника тех лет. Она встречалась в обучающей выборке, и цифры «1953» оказались правдоподобным продолжением текста. С другой — посмотрите на сами варианты: «нет, точнее…», «нет, разберём аккуратно» — модель дважды поправляет сама себя прямо внутри ответа, а набор ходов не имеет смысла: ходы нелогичные, местами несуществующие.
Никакого анализа не происходило — никто в этот момент не «подумал», может ли так сходить конь и есть ли этот конь на доске вообще. Все ролики про то, как LLM нелепо играют в шахматы, — ровно про это. Меня, честно говоря, больше поражает обратное: как ей вообще удаётся делать более-менее легальные ходы. Видимо, шахматных текстов в обучающей выборке действительно много.
Теперь дадим ей движок. Объявляем тулу analyze_chess_position — она запускает Stockfish на моём компьютере: настоящий перебор миллионов позиций, а не текстовая интуиция. На то же сообщение модель отвечает «Проанализирую позицию» и вызывает тулу:
{
  "name": "analyze_chess_position",
  "input": {"fen": "1rb4r/pkPp3p/1b1P3n/1Q6/N3Pp2/8/P1P3PP/7K w - - 1 0"}
}
{
  "bestmove": "b5d5",
  "verdict": "мат в 2 (форсированно)",
  "depth": 24,
  "main_line": "b5d5 b7a6 c7b8n"
}
Вердикт движка уезжает обратно в API как tool_result, и финальный ответ уже совершенно разумный:
Лучший ход: 1.Фd5+!
Далее форсированно:
— 1...Крxa6 (единственный ход, король уходит от шаха)
— 2.c8=К# — мат конём с превращения!
Красивая комбинация с превращением пешки в коня (недопревращение), дающим мат.
Потому что к моменту, когда модель писала текст, правильный ответ уже лежал внутри её сообщений.
Главное
Ответ LLM складывается из того, что уже есть у неё в контексте.
Мыслит модель или «просто предсказывает токены» — вопрос скорее философский: мы и сами достраиваем свою речь по слову за раз. Но у этой механики есть вполне практическое следствие: пока ответ рождается как самое вероятное продолжение текста, шанс вывести не ту цифру есть всегда. И именно от того, какие тулы вы дадите модели и насколько обогатите её контекст — поиском, вашей базой знаний, движком, тулой «сходить на биржу за актуальным курсом», — зависит, превратится ли машинка для достраивания текста в нереально полезный инструмент. Как мы видели: когда человек читает хороший ответ LLM, чаще всего этот ответ к моменту генерации уже лежал у неё в контексте.
Стопроцентной гарантии не даёт и это: убедиться, что из «176» в документе получится «176» в ответе, формально нельзя. Но когда вы кладёте модели документ, где рост записан, вероятность верного ответа несравнимо выше, чем когда она достраивает текст из ничего.
Поэтому мой практический совет: когда проектируете агента, который должен в чём-то помогать, хорошенько подумайте, какие тулы ему выдать. Что вы можете построить вокруг модели, чтобы она отвечала на основе того, что у неё уже есть, а не сочиняла?
Тем, что меня волнует в мире LLM, я делюсь в Telegram-канале — приходите почитать новости и заметки. Если есть вопросы, которые не дают покоя, — пишите в комментариях: пока я не настолько известная личность, чтобы не успевать отвечать. А если есть замечания конкретно к этому тексту — тоже не стесняйтесь, я переживу.